
Инциденты
Вы тоже хотите уволиться по три раза в год? Биг-босс работы на линии Лиза обещает себе это больше десяти лет, но каждый раз остаётся — потому что кто ещё разрулит чужую панику и поверит, что человек «ничего не трогал, оно само»?
Это статья о том, как работать в поддержке, когда у клиентов всё горит, а вы должны оставаться добрым, собранным и хотя бы немного живым.
Это статья о том, как работать в поддержке, когда у клиентов всё горит, а вы должны оставаться добрым, собранным и хотя бы немного живым.

Честно поговорили о том, как не ошизеть от работы в саппорте и всё ещё любить людей:
- Егор Сабанский5 лет руководит инцидент-менеджментом, фаундер Пульсара
- Юля БессметнаяПоддерживает поддержку, автор Второй линии
Чем инцидент отличается от бага
Инцидент-менеджмент — это как?
Что делать, если всё сломалось
Как стать инцидент-менеджером
Инцидент-менеджмент — это как?
Что делать, если всё сломалось
Как стать инцидент-менеджером
Чем инцидент отличается от бага
— Что такое инцидент? Каждый баг — это инцидент?
Инцидент — это всё, что ведёт к деградации ключевой функциональности, то есть той штуки, которая непосредственно влияет на бизнес и деньги. Например, когда всем недоступны оплаты или есть проблемы сетевой инфраструктуры, из-за которых пользователи вообще не могут получить доступ к сайту.

Инцидент в ITIL — это любое незапланированное прерывание работы ИТ-услуги или снижение качества её предоставления.
— То есть если баг заметили три человека за год, это не инцидент?
Даже если этот баг заметили вообще все пользователи, но он не ломает ключевую функциональность, это тоже не обязательно инцидент. Если на сайте начала моргать картинка, физически это раздражает, но на бизнес, репутацию или возможность пользоваться продуктом никак не влияет.
Или блоки на странице разъехались и стоят не как в макете у дизайнера: это тоже баг, но если информация при этом остаётся доступной и ключевая функциональность работает, инцидентом это не становится. А вот если уехала кнопка, которой пользователи должны совершить важное действие, надо смотреть, к чему именно привела проблема и насколько она влияет на ключевое действие. В общем, баги рождают инциденты, но не каждый баг становится инцидентом.
— Есть какая-то методология или бенчмарк, на которую можно ориентироваться при работе с инцидентами? Или каждая компания сама решает, что считать инцидентом?
Всё гибридно и ситуативно. Для разных компаний критично разное.
Есть стандартные критерии, которые описываются в практиках ITIL и других подходах к инцидент-менеджменту: недоступность чего-то ключевого или полная недоступность продукта. Это очень явные критерии, в реальности мы не всегда понимаем, насколько продукт аффектит то, что сломалось. Так бывает в крупных компаниях со сложной инфраструктурой и большим количеством сервисов — что-то отвалилось, но на что это влияет, сложно сказать, пока всё не загорелось.
Если горит, мы идём к бизнесу и спрашиваем: «Вот, что мы наблюдаем. Это насколько критично?»
Поддержка может предположить, что это инцидент, потому что пользователи страдают и напишут про нас в твиттер плохо, но бизнес смотрит на ситуацию шире: «Продажи идут, юридических и репутационных рисков не видим, значит, не критично». Остаётся исходить из этой позиции. Если даже на вроде ОЧЕВИДНЫЙ инцидент бизнес говорит: «Мы понимаем риски и готовы взять их на себя», — мы киваем головой. Для инцидент-менеджмента продуктовая позиция в этом смысле важнее учебника или собственного ощущения того, что происходит.
Это не значит, что каждый раз нужно бегать спрашивать: «А это точно инцидент?» Для этого должны быть инструкции — ранбук.
— Что должно быть в ранбуке?
Главное, чтобы был порядок действий. Например, если срабатывает алерт, мы открываем инструкцию и видим, куда бежать: сначала к дежурным, проверяем состояние сервиса, смотрим логи, перезапускаем нужный компонент, проверяем, восстановилась ли работа. Если ранбук помог, заканчиваем на этом и ни у кого не спрашиваем.
Если инструкций нет или они не помогают, тогда уже эскалируем проблему и идём к бизнесу согласовывать, как тушить будем.


Photograph: Lee Scott / Unsplash
Инцидент менеджмент — это как?
— А насколько вообще развит процесс инцидент-менеджмента в обычной российской компании? Ну в средней какой-то.
Проблема в том, что многие компании не понимают, зачем вообще это нужно. Выглядит как муть: зачем каждый раз дёргать разработку по каким-то непонятным поводам? Напридумывали инцидентов, баг зафиксируйте и никого не дёргайте.
Отдельная команда инцидент-менеджмента, особенно если она не находится внутри поддержки, — это история для очень развитых компаний и крупных продуктов. Им важно не только продавать свои услуги и продукты, но и следить за тем, что с ними происходит после продажи.
В обычной российской компании отдельного инцидент-менеджмента может вообще не быть. Есть несколько сотрудников технической поддержки, которые одновременно делают всё: принимают обращения, отвечают пользователям, эскалируют проблемы разработчикам. Если на них внезапно начинает лететь большое количество однотипных обращений, они понимают, что происходит что-то необычное, тогда идут в разработку. Фактически функции инцидент-менеджеров они выполняют, но на невысоком уровне и совмещая со всем на свете.
Это нормально, если вы маленькие. По мере развития продукта зоны ответственности начинают расходиться: поддержка, разработка и инцидент-менеджмент расходятся по разным углам.
— Тогда давай разделим зоны ответственности: есть поддержка, продукт, сервис, бизнес и отдельный инцидент-менеджер. Какая у последнего роль?
Инцидент-менеджер не решает проблему технически. В этом его принципиальное отличие от поддержки.
Если поддержке неизвестно, что происходит, потому что у неё нет мониторинга или чёткого понимания ситуации, на первых порах они всё равно попытаются что-то исправить, давать какие-то рекомендации, и только когда понимает, что своими инструкциями не справляется, эскалирует проблему дальше.
А команда инцидент-менеджмента изначально не должна обладать глубокой технической экспертизой конкретного продукта. Их задача — реагировать на всплеск, понимать, где функция важная, где не очень; знать, кто за неё отвечает, и организовывать людей вокруг решения проблемы. Инц-менеджер должен точно знать, кто со стороны бизнеса и технических команд может подключиться к решению: кто отвечает за конкретный сервис, кто разработчик, кто деповс, кто технический директор, чем они могут помочь. Это вопросы «что, куда, кому», но не «как». Мы фасилитируем максимально быстрое завершение инцидента, но сами его не чиним.
В мире здорового человека команда инц-менеджмента должна быть достаточно независимой и подчиняться непосредственно техническому директору, чтобы оставаться непредвзятой и не зависеть от разработчиков. Только так можно чувствовать себя безопасно и не переживать, что ты сейчас укажешь на чей-то косяк, который привёл к катастрофе, а тебя потом обвинят в некомандной работе.

Что делать, если всё сломалось
— Я саппорт на линии, работаю в поддержке и подозреваю, что начинается инцидент. Что мне делать? Какие вопросы задавать, какую информацию собирать и как правильно подать сигнал?
Если ты как сапорт подозреваешь, что что-то отвалилось или стало недоступно, скорее всего, сама ты ничего не починишь: у тебя нет нужной экспертизы, доступов и прав. Поэтому главное правило очень простое: ничего не можешь сделать — эскалируй.
Ты можешь посмотреть, что происходит: если резко выросло количество обращений, посмотреть, что пишут пользователи, проверить, одна и та же ли там проблема, но на сбор информации не должно уходить много времени. Допустим, ты за три минуты посмотрела обращения и поняла: «У нас не работает кнопка, пользователи массово об этом пишут, вот несколько примеров» — этого уже достаточно, чтобы передать сигнал дальше.
Если у тебя есть вторая или третья линия поддержки, разработка — эскалируй туда. Параллельно сообщи своему руководителю. Не надо проводить полноценное расследование и собирать массив данных, прежде чем сообщить о проблеме. Инициативные могут дополнительно спросить: «Что отвечать пользователям? Какой номер у инцидента? Можем ли мы массово сообщить о проблеме?», но честно говоря, ответы на эти вопросы и так должны быть учтены в процессе.
Если технически возможно привязать обращения к инциденту, это вообще отлично: у вас появляется задача с номером, к которой можно прикреплять все обращения по теме, так считать быстрее. Очень полезно, когда во время инцидента поддержка тоже остаётся в курсе происходящего. Ей нужно понимать, что сейчас делают технические команды, когда примерно ожидается восстановление и что там у пользователей.

Карточка инцидента в Пульсаре: видно количество привязанных обращений, статус работ, лог действий
Если бизнес может сам подготовить сообщение для пользователей о проблеме — ещё лучше.
Можно разместить информацию о недоступности прямо на сайте. Статус-страница снижает количество обращений и одновременно показывает пользователям, что мы уже знаем о проблеме и чиним.
Можно разместить информацию о недоступности прямо на сайте. Статус-страница снижает количество обращений и одновременно показывает пользователям, что мы уже знаем о проблеме и чиним.
— Что саппорту точно не стоит делать при подозрении на инцидент?
Разбираться самостоятельно, как это починить.
Если это действительно инцидент — технический сбой или критическая недоступность, — 99%, что причина находится за пределами компетенций поддержки. У тебя физически может нет доступа к инструментам, которые нужны для исправления проблемы.
Если ты в это время начинаешь долго выяснять детали, уточнять что-то у пользователя и самостоятельно искать решение, ты увеличиваешь время от начала инцидента до начала его устранения.
Это влияет на метрики доступности:
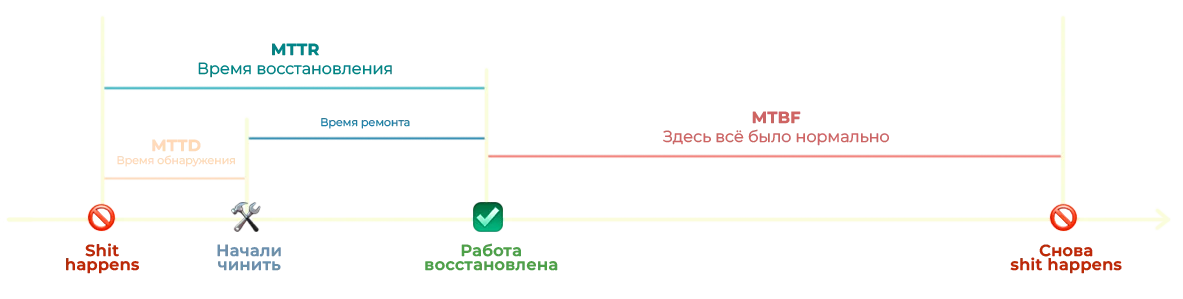
Особенно если ты один из немногих сотрудников на линии. А если таких сотрудников много, ситуация ещё хуже: вместо того чтобы эскалировать проблему, десять человек начинают одновременно её исследовать.
Поэтому твоя задача — быстро понять, что что-то сломалось, и быстро это эскалировать.
Точно не стоит замалчивать проблему: если на линию начинает валиться огромное количество обращений, тебе же потом их вручную разгребать. Как всегда, пользователи будут задавать дополнительные вопросы, просить компенсации, объяснения, извинения. Ты потратишь на это огромное количество времени, а компания параллельно продолжит терять деньги и копить репутационные риски.
— Какой минимальный набор инструментов должен быть у поддержки, чтобы нормально работать с инцидентами?
1️⃣ Алерты
Я даже не говорю про полноценную систему мониторинга, где можно открыть график, поставить фильтры, сравнить динамику с прошлым периодом и так далее, нужны хотя бы уведомления на основные метрики. Например, если порог превышен или какая-то система перестала отвечать, должно прийти простое сообщение: метрика, сервис, ожидаемое значение и фактическое значение. Уже можно будет реагировать.

Карточка инцидента в Пульсаре: видно количество привязанных обращений, статус работ, лог действий
В идеале рядом с алертом должен быть ранбук, который всем одинаково объяснит, что делать после алерта. Если ранбука нет, можно хотя бы на словах договориться, куда бежать.
2️⃣ Матрица эскалаций
Обычная таблица, где написано, какие есть продукты и сервисы, кто за что отвечает, кто руководит ответственными, и как с этими людьми связаться.
2️⃣ Матрица эскалаций
Обычная таблица, где написано, какие есть продукты и сервисы, кто за что отвечает, кто руководит ответственными, и как с этими людьми связаться.

Карточка инцидента в Пульсаре: видно количество привязанных обращений, статус работ, лог действий
Если дежурный недоступен, должен быть второй человек, которому можно позвонить. Если недоступен и второй — ищем их руководителей и передаём им. Иногда приходится доходить до CTO, CEO или фаундера. Это бывает, если проблема критическая, надо звонить во все колокола.
3️⃣ Пространство для коммуникации во время инцидента
В мире здорового человека — это общий звонок, где все на месте. Если созваниваться не нужно, то чат, в который вы скидываете все артефакты инцидента: что сейчас происходит, что делает один человек, что другой, к чему это приводит, какие гипотезы и кого ещё нужно подключить.
Лучше всего, когда на каждый инцидент автоматически создаётся таск. В таск кидают важные вехи (добавляют исполнителей, меняют статусы) инцидента, чат автоматически привязывается к таску, в чат из таска улетает всё важное. По таску будет легко восстановить историю инцидента, а в чате вы оперативно что-то обсуждаете.
4️⃣ Отчётность после инцидента
Её называют по-разному: постмортем, post-incident review, PIR. Суть одна — это короткий документ или таск, в котором фиксируется, когда произошёл инцидент, что произошло, почему это произошло, как проблему исправили и что мы делаем, чтобы она не повторилась.

Карточка инцидента в Пульсаре: видно количество привязанных обращений, статус работ, лог действий
— Какие метрики отслеживать в первую очередь, если сейчас вообще никаких алертов нет?
Зависит от бизнеса. Пока вы маленькие, начните с самых очевидных вещей: оплаты, логины, общая доступность сайта, например, открывается сайт или нет, доступен ли он из разных точек.
Когда инфраструктура сложная, нужны не только базовые уведомления, но и система мониторинга: на состояние серверов, память, количество запросов к внутренним сервисам, сертификаты и лицензии, без которых всё развалится. Про один сертификат забудете и сотрудники внезапно перестанут подключаться к корпоративной сети. Работа встанет из-за мелочи.
Принцип простой: метриками нужно покрывать всё, что критично для бизнеса.

Как стать инцидент-менеджером
— Какие технические навыки нужны саппорту, который хочет перейти в инцидент-менеджмент?
Я бы сначала задумался: действительно ли вы хотите расти именно в инцидент-менеджмент? Это не обязательно следующий уровень после поддержки. У саппортов и инц-менеджеров дальнейшее развитие примерно в одну сторону: разработка, девопсы, продуктовые и проектные менеджеры, короче, как у всех.
Переходить в инцидент-менеджмент стоит либо потому, что вам действительно интересно ковыряться с пожарами, либо потому, вы хотите развиваться в направлениях надёжности, наблюдаемости и стабильности систем.
✅ Точно нужно уметь
- Понимание того, как устроена поддержка в целом: какую функцию выполняет поддержка, разработчики, девопсы, техлиды, продуктовая команда и так далее. Общее понимание архитектуры продукта и того, как разные команды взаимодействуют.
- Системы мониторинга: пригодятся графана, кабана или другие системы мониторинга, умение читать и выгружать логи.
- SQL: очень хорошо, если человек умеет работать с базами данных и писать хотя бы простые запросы SELECT/INSERT/UPDATE/DELETE.
- API и документация: полезно понимать, как работать в постмане и уметь работать со сваггером или похожими инструментами документирования. Достаточно понимать, что это вообще такое и как составить запрос по документации.
- Процесс алерта: понимать, что такое алерт, как он работает, почему он сработал и как настраивать новые.
🤔 Не лишнее, но такое
- Линукс: глубоко знать необязательно. Если компания активно работает с серверами, конечно, будет плюсом, но для самого инц-менеджера знания на уровне системного администратора будут лишними.
- Сети и маршрутизация: базовое понимание может пригодиться, но это не фундаментальное требование.
- Докер и кубер: достаточно просто понимать, что такое контейнеры и поды. Это дополнительный плюс.
- Языки программирования: это на новый год для развития. Если хотите переехать в продукт или техническое направление, для общего образования полезно.
Самая базовая база — это системы мониторинга, логи, базы данных, API и понимание самого процесса инцидент-менеджмента: зачем он существует, какую ценность создаёт и почему его вообще нужно применять.
Если на собеседовании на позицию инцидент-менеджера от вас требуют прямо глубокого знания всех этих технологий, вопрос к самой роли. Нанимающая команда, видимо, ожидает, что вы будете использовать их в работе. Они странно представляют роль разруливателя инцидентов.
— То есть саппорту не нужно пытаться стать разработчиком, прежде чем идти в инцидент-менеджмент?
Нет, это важно разделять: во время инцидента команда разработки должна что-то починить, и ваша задача не в том, чтобы чинить вместе с ними. Чем больше времени инцидент-менеджер тратит на самостоятельный сбор и анализ данных, тем больше времени инцидента теряем. Если тебе нужно пять минут, чтобы собрать необходимую информацию, это отлично, но если от тебя ждут, что ты полчаса читаешь логи, пишешь сложные запросы и разбираешься в архитектуре, ты делаешь что-то не то. Погруженный в эту зону специалист справился бы за минуту, оставьте ему его работу. Инц-менеджер должен собрать ровно столько информации, сколько необходимо команде, которая будет устранять проблему.
Главное — быстро организовать правильных людей вокруг инцидента, передать им фактуру и не мешать технической команде заниматься тем, что она умеет лучше всего: чинить систему.
📚 Эти ссылки подобрали для вас вручную:
Как отдыхать, чтобы отдохнуть
Если вы уже отлежали себе бока диваном и готовы с него подняться, время задуматься о качественном отдыхе: регулярных приятных делах, который вы запланируете и устроите себе сами.
Как не утонуть в рутине работы в поддержке
Поддержка — это не только бесконечные тикеты и шаблонные ответы. Делайте работу живее и интереснее — для себя и для пользователей. Собрали классные способы не сгореть в рутине, прокачать скиллы и даже получать кайф от процесса.
Кем стать, когда вырастешь: карьерный трек в саппорте
Если у России, как известно, три пути, то у специалиста поддержки — намного больше.
Ветеран vs новичок: как меняет людей работа в поддержке
Задали новичку и опытному саппорту одинаковые вопросы про работу и жизнь. Сравнили их ответы — получился гайд по превращению из энтузиаста в циника. Решайте, на чьей вы стороне: тех, кто ещё верит в людей, или тех, кто уже сомневается.
Как получать повышения легко и приятно
Парадокс: одни годами отвечают на тикеты, а другие стремительно растут в карьере. Ну и почему так несправедливо?